













Cuando las GPU escalan, las redes deciden el resultado
La IA está entrando en una era en la que los clusters crecen más rápido de lo que nadie esperaba. Miles de GPU se convierten en decenas de miles y luego el siguiente paso es simplemente más. Sin embargo, muchos equipos descubren una verdad incómoda: agregar computación no siempre aumenta el rendimiento. A medida que los modelos crecen, la sobrecarga de comunicación aumenta, la sincronización se vuelve más pesada y la red se convierte en un cuello de botella silencioso.
Aquí es donde surge una nueva regla. En el entrenamiento moderno de IA, el verdadero techo a menudo no es el acelerador-sino la estructura. Si su interconexión no puede seguir el ritmo, pagará por una computación costosa que espera, inactiva y consume energía sin ofrecer resultados.

Por qué los AI Fabrics necesitan un salto óptico de clase 1,6T-
Los tejidos de IA están diseñados para una misión: mantener los datos en movimiento a escala. Sin embargo, las generaciones tradicionales de interconexión no fueron diseñadas para la intensidad de comunicación de la capacitación distribuida masiva. La congestión, la mayor latencia bajo carga y el aumento de la fricción aparecen exactamente cuando más se necesita estabilidad.
Una capa óptica de 1,6T no es una actualización por el bien de los números. Más bien, es una respuesta práctica a la realidad actual de la IA: mayor tráfico de este a oeste, conmutación más densa y envolventes de energía más estrictas. Cuando el ancho de banda de su estructura crece, el clúster se vuelve más informático y menos espera.
Este salto también proporciona un respiro para la innovación. Los ingenieros pueden explorar nuevas estrategias de paralelización, experimentar con lotes de mayor tamaño y diseñar modelos más complejos porque la red ya no es el eslabón más débil. La clase 1.6T permite a los desarrolladores centrarse en avances algorítmicos en lugar de limitaciones de la red.

1.6T OSFP-XD DR8+: diseñado para una interconexión de IA densa y de corto-alcance
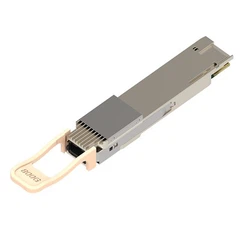
El transceptor OSFP-XD DR8+ 1.6T está diseñado para ofrecer un rendimiento agregado de 1600G a través de fibra monomodo-con modulación PAM4, diseñado para admitir la próxima ola de redes de IA. Su factor de forma OSFP-XD permite una alta densidad de puertos, mientras que la arquitectura DR8 se alinea naturalmente con las modernas estructuras de hojas donde dominan los enlaces de corto-alcance y alto-rendimiento.
Más importante aún, equilibra el desempeño con la realidad operativa. Los centros de datos de IA se preocupan por el margen térmico, la distribución de energía y la estabilidad del sistema, no solo por la velocidad de la línea. Con una disipación de potencia inferior a 25 W, el módulo está posicionado para admitir escala sin forzar un rediseño de su estrategia de enfriamiento.
El cumplimiento del módulo con IEEE 802.3df y la alineación con los acuerdos de múltiples fuentes OSFP-XD brindan garantía de interoperabilidad. Es conectable en caliente y admite interfaces de administración estándar, lo que simplifica la implementación.
Del "ancho de banda bruto" a la "eficiencia de clúster utilizable"
En la infraestructura de IA, la diferencia entre el ancho de banda teórico y el rendimiento real lo es todo. Una estructura puede parecer rápida en el papel y, aun así, ralentizar el entrenamiento debido a retrasos en la sincronización, patrones de tráfico desiguales y problemas de suscripción excesiva. La interconexión óptica adecuada le ayuda a recuperar esa eficiencia perdida.
Con enlaces de 1,6 T, puede aumentar la capacidad de la red por puerto, simplificar la planificación de la topología y reducir la presión sobre el número de cables y las capas de agregación. Como resultado, el tejido se convierte en un facilitador del rendimiento en lugar de una limitación constante. La reducción de la dispersión de cables también se traduce en un mantenimiento más sencillo y un menor riesgo de errores durante las actualizaciones.
Diseñado para los operadores que se ganan la vida escalando la IA
Los centros de datos de IA no solo son más grandes - sino que también son más sensibles. Los operadores deben manejar un crecimiento masivo mientras mantienen bajo control el tiempo de actividad, la capacidad de servicio y los costos de energía. Es por eso que el OSFP-XD DR8+ 1.6T se centra en requisitos prácticos de implementación: diseño conectable en caliente, interfaz de administración estandarizada (I2C) y rango de temperatura de funcionamiento compatible con el-centro de datos-.
A medida que sus clústeres se expanden, necesita una infraestructura que escale sin problemas. Necesita ópticas que mantengan la estructura predecible, mantenible y consistente - especialmente durante las actualizaciones y expansiones de capacidad. Un enfoque modular reduce el tiempo de inactividad y brinda a los operadores la confianza para implementar nueva capacidad sin interrumpir las cargas de trabajo en curso.
Dónde encaja mejor
Este módulo es ideal para estructuras de entrenamiento de IA, clústeres de inferencia-a gran escala y entornos de conmutación a hiperescala que exigen alta densidad y una implementación rápida. Admite la capa de interconexión óptica de corto-alcance donde fluye la mayor parte del tráfico de IA, conectando conmutadores de alta-velocidad y nodos de computación en racks, filas o segmentos de sala de datos.
Cuando su objetivo es acelerar el tiempo-para-entrenar y mantener una alta utilización, la capa óptica debe ser tan avanzada como la capa informática. Ese es el papel que debía desempeñar el 1.6T.

Conclusión: cree redes de inteligencia artificial que no limiten la computación con inteligencia artificial
La inversión en IA se mide en GPU, pero el éxito de la IA se mide en rendimiento, estabilidad y velocidad de iteración. Si el tejido se convierte en el cuello de botella, todo el clúster pierde valor. El OSFP-XD DR8+ 1.6T está diseñado para eliminar ese cuello de botella y ayudar a que su infraestructura de IA escale con confianza.
Cuando pasa a 1.6T, no solo está comprando un módulo más rápido. Estás comprando un tejido que se adapta a tus ambiciones - para que tus GPU puedan dedicar más tiempo a entrenar y menos a esperar. Al invertir hoy en una capa óptica-con visión de futuro, se posiciona para adoptar las arquitecturas modelo del mañana sin dudarlo.


